> For the complete documentation index, see [llms.txt](https://cleyrop.gitbook.io/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://cleyrop.gitbook.io/docs/v4.7/projet-data-and-ia/datasets/politique-de-schema.md).

# Politique de schéma

Choisissez comment un dataset réagit lorsque les nouvelles données n'ont pas exactement le même schéma que lui.

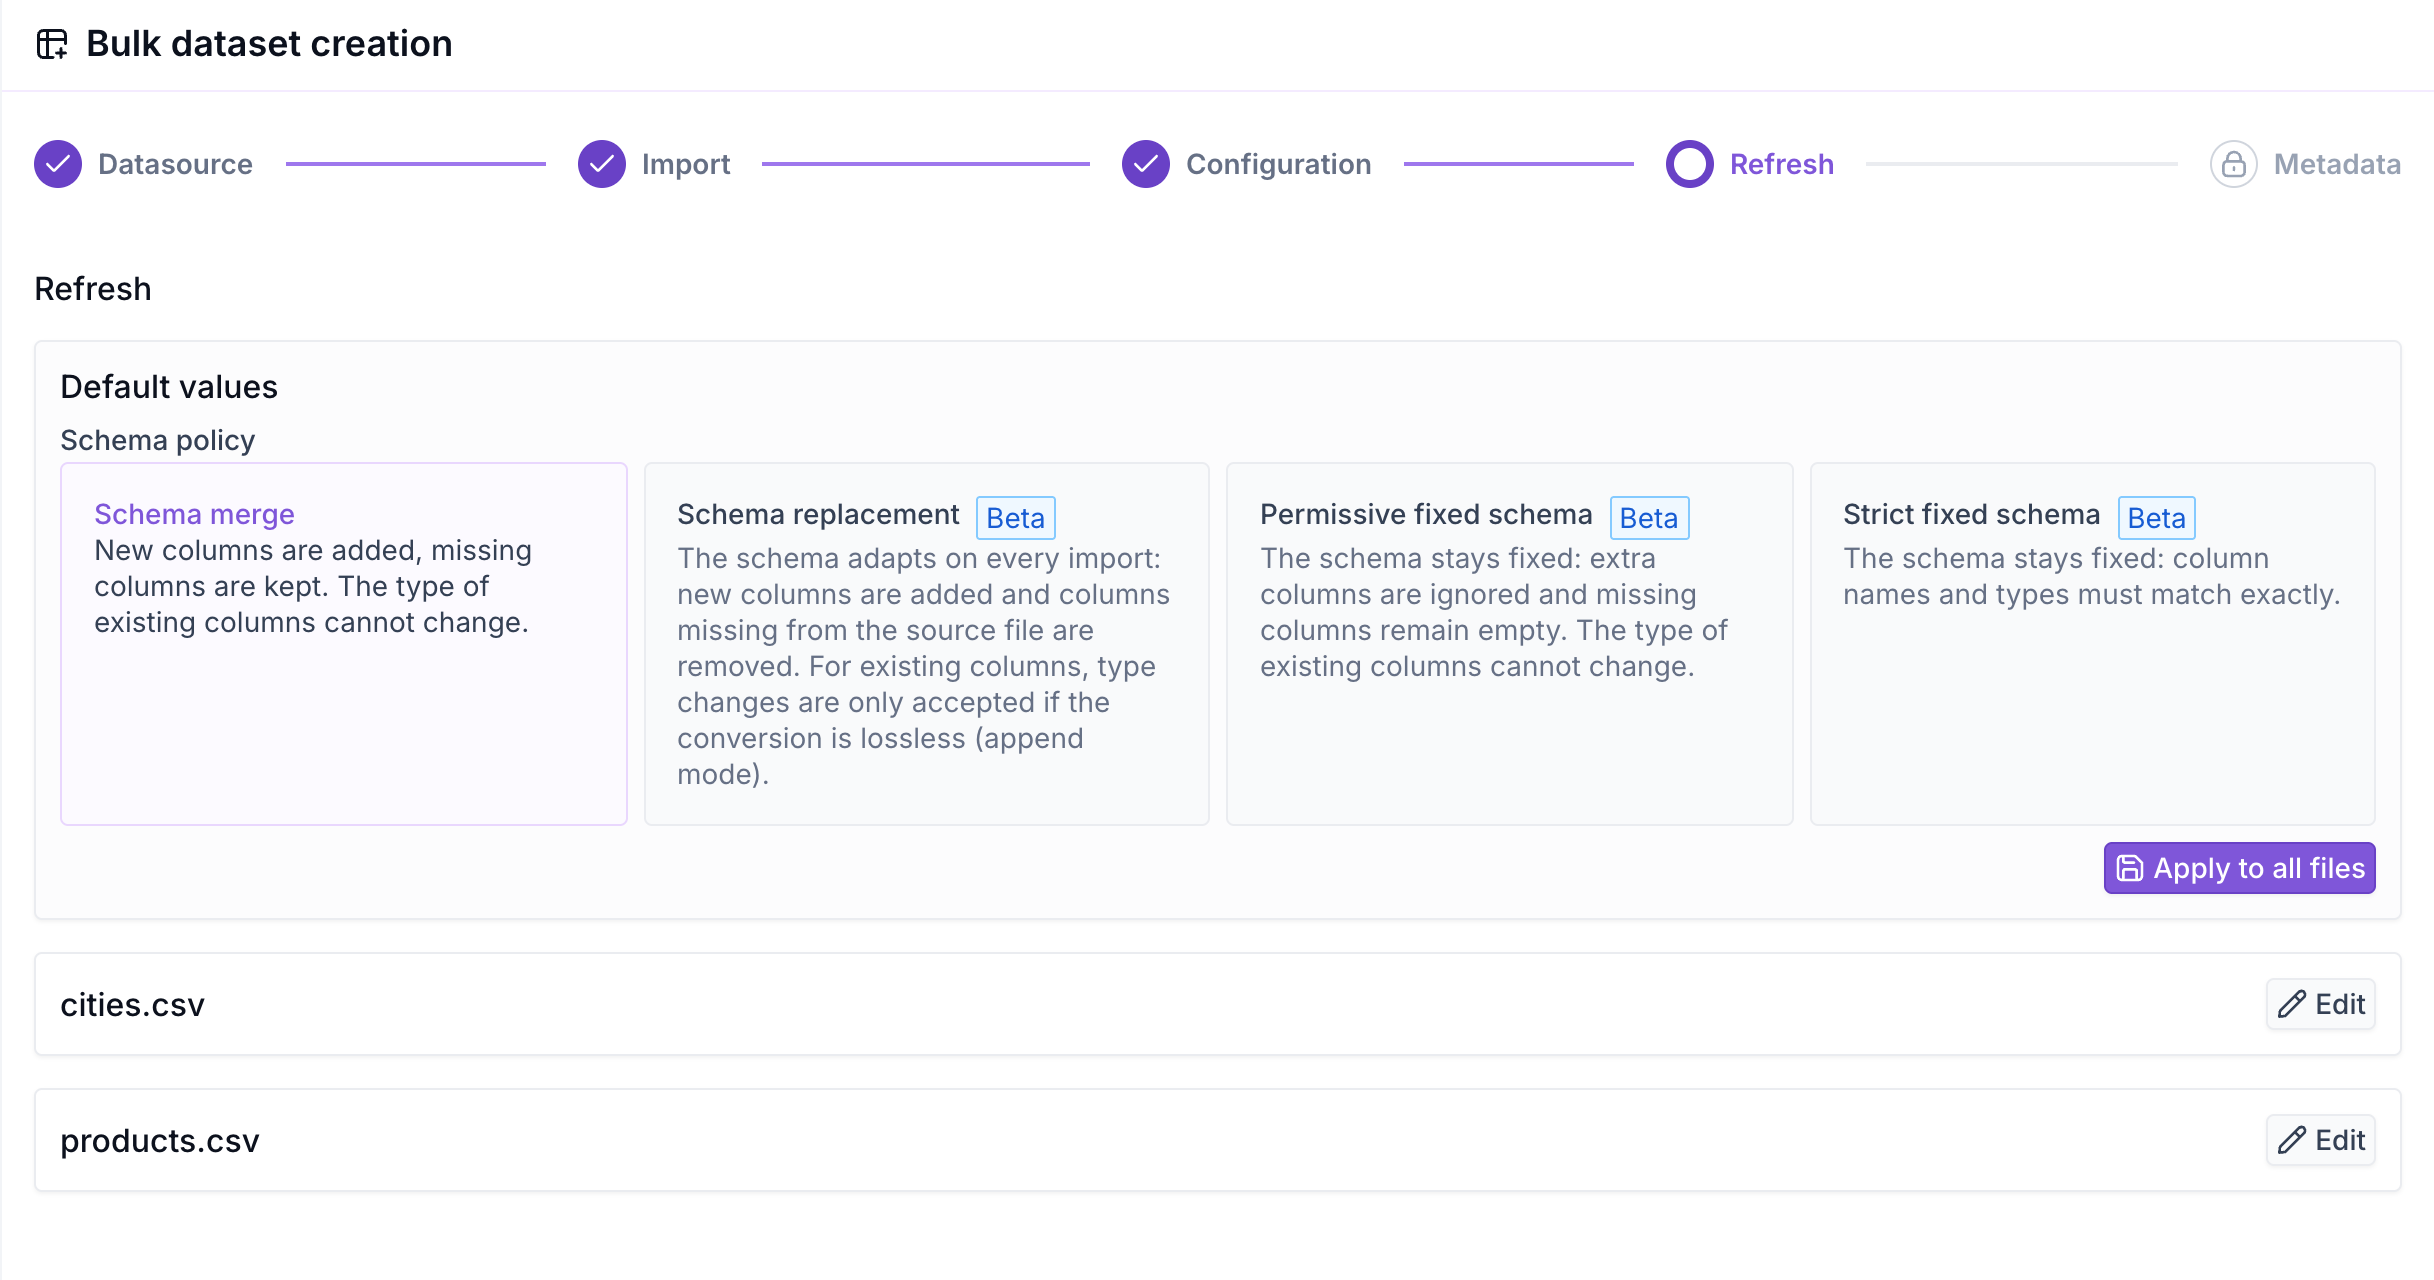
La **politique de schéma** définit ce qui se passe lorsque les nouvelles données (nouveau fichier, rafraîchissement d'une datasource, exécution d'un Dataflow) n'ont pas exactement le même schéma que le dataset : colonnes en plus ou en moins, changement de type.

Elle est demandée à l'étape **Rafraîchissement** de la création de tout dataset (import local, datasource, import multiple) et dans les métadonnées d'un dataset de sortie de Dataflow.

***

## Les quatre politiques

<table><thead><tr><th width="230">Politique</th><th>Comportement</th></tr></thead><tbody><tr><td><strong>Fusion de schéma</strong> (par défaut)</td><td>Les nouvelles colonnes sont ajoutées, les colonnes manquantes sont conservées avec des valeurs vides. Le type des colonnes existantes ne peut pas changer.</td></tr><tr><td><strong>Remplacement de schéma</strong> <mark style="background-color:blue;">bêta</mark></td><td>Le schéma s'adapte à chaque import : les nouvelles colonnes sont ajoutées et les colonnes absentes des nouvelles données sont supprimées. Pour les colonnes existantes, un changement de type n'est accepté que si la conversion se fait sans perte de données.</td></tr><tr><td><strong>Schéma fixe permissif</strong> <mark style="background-color:blue;">bêta</mark></td><td>Le schéma reste fixe : les colonnes supplémentaires sont ignorées et les colonnes manquantes restent vides. Le type des colonnes existantes ne peut pas changer.</td></tr><tr><td><strong>Schéma fixe strict</strong> <mark style="background-color:blue;">bêta</mark></td><td>Le schéma reste fixe : les noms et les types de colonnes doivent correspondre exactement, sinon l'import est rejeté.</td></tr></tbody></table>

Dans tous les cas, un changement de type impossible (par exemple une colonne texte vers un nombre) rejette le fichier : la fiche de rafraîchissement indique la colonne en cause.

<figure><img src="https://content.gitbook.com/content/Lve2h8CdCFZ7rIwwaoUU/blobs/bPpQAZHhOTYguYFiiWND/4.7-bulk-schema-policy.png" alt="Sélecteur de politique de schéma à l&#x27;étape Rafraîchissement"><figcaption></figcaption></figure>

{% hint style="warning" %}
La politique de schéma se choisit **à la création** du dataset et n'est plus modifiable ensuite, y compris pour un import local. Elle est visible dans l'onglet **Informations** de la fiche du dataset. Pour en changer, créez un nouveau dataset.

Pour un dataset de sortie de Dataflow, elle se définit sur la branche `main` tant que le Dataflow n'est pas déployé en production.
{% endhint %}

## Plusieurs fichiers pour un même dataset

Lorsque plusieurs fichiers alimentent **un seul** dataset (import local de plusieurs fichiers, rafraîchissement multi-fichiers, dépôt SFTP ou SharePoint), le traitement dépend du **mode de rafraîchissement** :

* **Remplacement** (*replace*) : les fichiers sont d'abord agrégés entre eux selon la logique de **fusion de schémas** (colonnes de même nom de même type, colonnes manquantes renseignées à vide) pour former une table intermédiaire unique. C'est cette table qui est ensuite confrontée au dataset : le rafraîchissement réussit ou échoue selon la politique de schéma du dataset et la cohérence entre la table intermédiaire et le schéma cible.
* **Ajout** (*append*) : les fichiers sont traités **un par un** ; chacun est confronté au dataset selon sa politique de schéma. Un fichier rejeté n'empêche pas l'intégration des autres.

{% hint style="info" %}
Pour obtenir un dataset par fichier plutôt qu'un dataset unique, utilisez l'[import multiple](/docs/v4.7/projet-data-and-ia/datasets/gerer-les-datasets.md#creer-plusieurs-datasets-en-une-fois-import-multiple).
{% endhint %}

## Politique de schéma et modification manuelle du schéma

Après avoir [renommé ou supprimé une colonne](/docs/v4.7/projet-data-and-ia/datasets/modifier-le-schema-dun-dataset.md), un nouvel import du fichier d'origine se comporte selon la politique :

* avec **Fusion de schéma**, la colonne renommée ou supprimée est recréée, car l'en-tête du fichier ne correspond plus à aucune colonne du dataset ;
* avec **Schéma fixe strict**, l'import est rejeté.

Adaptez vos fichiers sources après une modification de schéma.

***

## Bonnes pratiques

* **Fusion de schéma** convient à la plupart des usages : elle absorbe les colonnes qui apparaissent sans casser les rafraîchissements.
* **Schéma fixe strict** garantit la conformité de données réglementaires ou contractuelles : tout écart est détecté immédiatement.
* **Remplacement de schéma** est adapté aux sources dont la structure évolue souvent, en gardant à l'esprit que les colonnes disparues sont supprimées du dataset.